
Spring Boot Microservice-ləri ilə Kripto Trading Platformasının Arxitekturası
Spring Boot Microservice-lər ilə Kripto Trading Platforması Qurarkən Nələri Öyrəndim?
Bir istifadəçi trading platformasına daxil olur.
Qeydiyyatdan keçir, hesabına daxil olur və qarşısına bazar ekranı çıxır. Bitcoin seçir, qiyməti real-time izləyir və nəhayət “Buy” düyməsinə basır.
İstifadəçinin gördüyü proses əslində çox sadədir. Amma backend üçün bu, cəmi bir neçə addım deyil.
İstifadəçi qeydiyyatdan keçəndə məlumatları Auth Service-ə gedir, hesab yaradılır və istifadəçi üçün əlavə proseslər başladılır. Login zamanı JWT yaradılır və sonrakı request-lər API Gateway üzərindən keçir. Gateway tokeni yoxlayır, istifadəçinin hansı icazələrə sahib olduğunu müəyyən edir və request-i uyğun service-ə yönləndirir. İstifadəçi Bitcoin səhifəsini açanda isə başqa bir proses başlayır. Market məlumatları Binance-dan alınır, sistem daxilində paylaşılır və WebSocket vasitəsilə frontend-ə çatdırılır. İstifadəçi “Buy” düyməsinə basanda artıq bir neçə service birlikdə işləməlidir. Request əvvəlcə Gateway-ə gəlir. Sonra Order Service işə düşür, istifadəçinin balansının kifayət edib-etmədiyi yoxlanılır və lazım olan məbləğ reserve olunur. Bundan sonra Binance-a order göndərilir. Binance order-in vəziyyətini dəyişdikcə bizim sistem də bunu izləyir. Order uğurla icra olunarsa, wallet yenilənir.
İstifadəçi üçün bütün bunlar bir neçə klikdir. Backend üçün isə authentication, authorization, database, cache, message broker, internal service communication, external API və real-time connection-lar eyni prosesin bir hissəsinə çevrilir. Və burada əsas suallar başlayır.
Binance order-i qəbul etdi, amma bizim service cavabı ala bilmədi. Bəs balansda nə olacaq?
WebSocket connection kəsilsə, order-in həqiqi vəziyyətini necə biləcəyik?
Admin permission dəyişsə, Gateway köhnə məlumatla işləməyə davam etməyəcəkmi?
Market məlumatını çox sayda istifadəçiyə necə çatdırmaq olar?
Qurduğum bu layihədə mənim üçün əsas maraq məhz bu suallar oldu. Məqsədim sadəcə işləyən bir kripto application yazmaq deyildi. Daha çox real bir distributed sistem qurarkən hansı problemlərin ortaya çıxdığını, hansı texnologiyanın hansı problemə uyğun gəldiyini və sistem böyüdükcə bugünkü düzgün qərarların sabah necə problemə çevrilə biləcəyini görmək istəyirdim. Nəticədə ortaya bu arxitektura çıxdı:
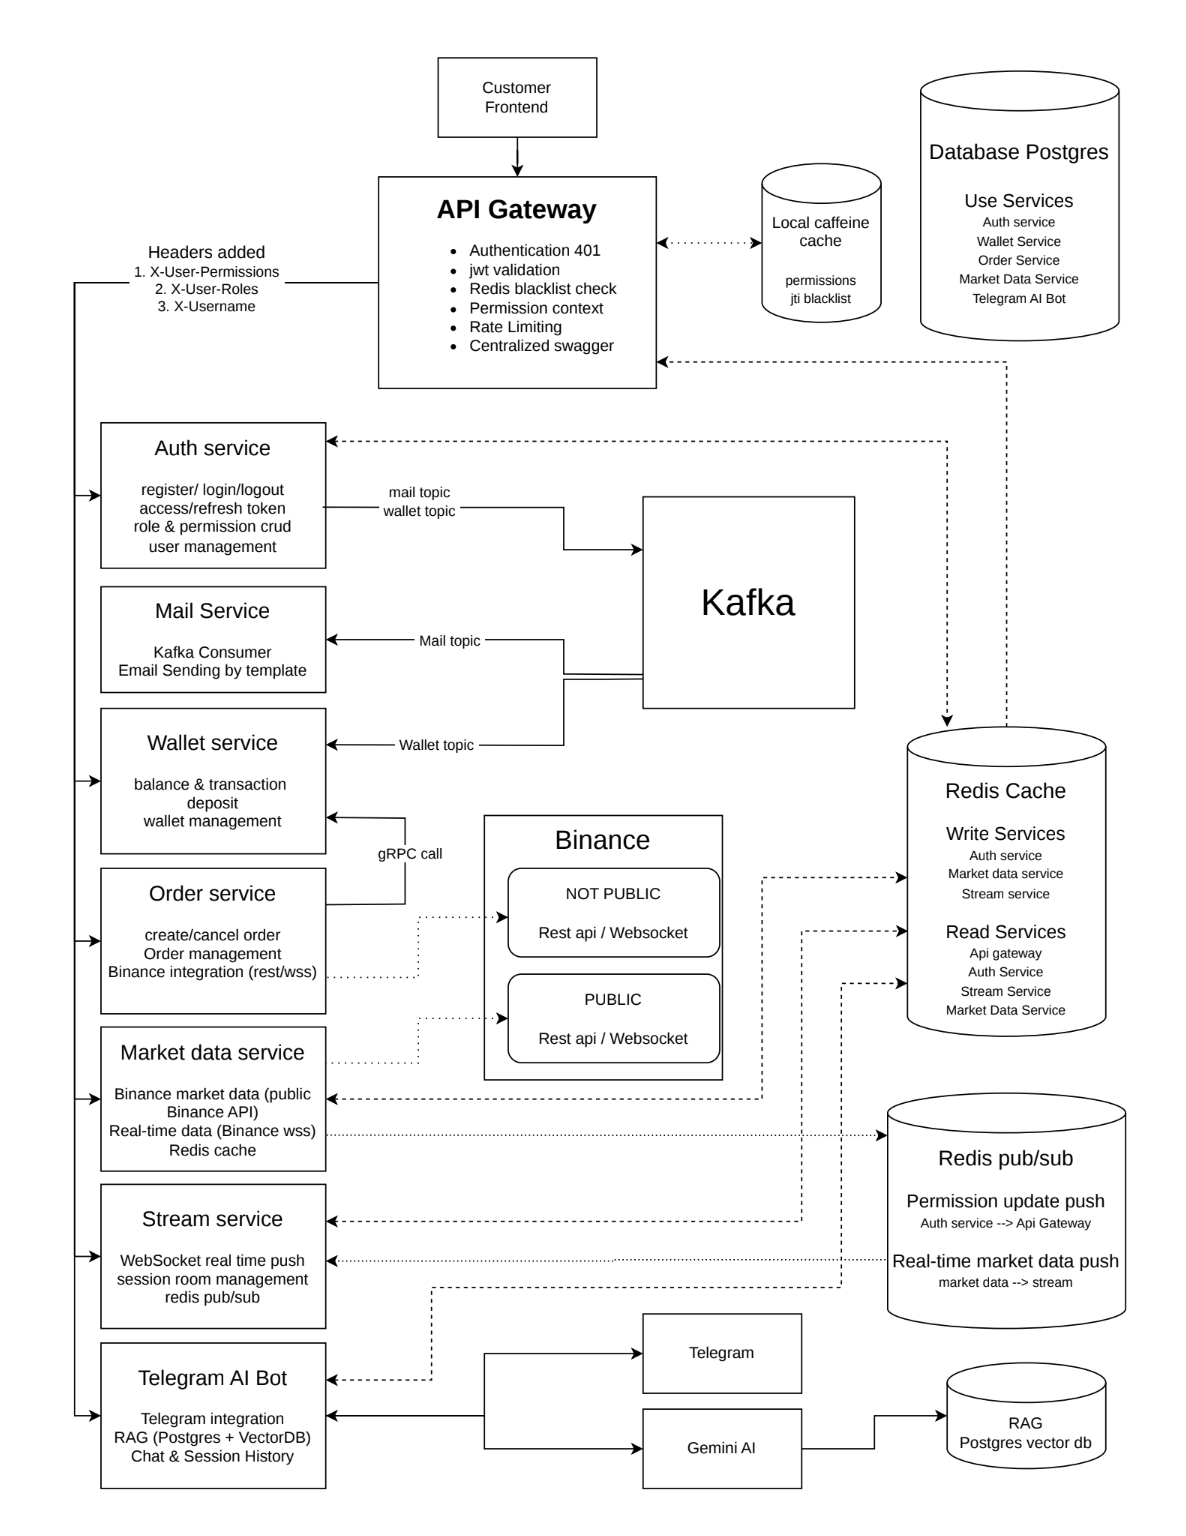
Bu yazıda sadəcə hansı texnologiyadan istifadə etdiyimi yox, daha çox niyə belə etdiyimi danışacağam.
Sistemi niyə ayrı-ayrı service-lərə böldüm?
Əvvəlcə çox sadə bir sual yaranırdı: bütün sistemi bir Spring Boot application daxilində yazmaq daha asan olmazdımı?
Əlbəttə, daha asan olardı.
Bir application, bir database, bir security configuration və bir deployment ilə başlanğıc mərhələdə hər şey daha rahat görünür. Amma sistemə yeni funksiyalar əlavə etdikcə bu rahatlıq yavaş-yavaş itir.
Məsələn market məlumatlarının çoxalması ilə yaranan yükün Wallet Service-ə təsir etməsini istəmirəm. Email göndərməkdə problem yarananda order yaratma prosesi dayanmalı deyil. Telegram botunda problem olduqda trading hissəsi işləməyə davam etməlidir.
Buna görə sistemi microservice-lərə ayırdım. İstifadəçi və authentication məsələləri Auth Service-də qaldı. Balans və transaction-lar Wallet Service-ə verildi. Order-lərin idarə olunması və Binance integration Order Service-ə keçdi. Market məlumatları ayrıca Market Data Service tərəfindən idarə olundu. Frontend WebSocket connection-ları üçün isə Stream Service yaratdım. Email və Telegram AI kimi əlavə funksiyalar da öz service-lərində saxlanıldı.
Beləliklə hər service-in konkret bir işi oldu. Amma service-ləri ayırmaqla problem bitmədi. Əsas sual bundan sonra başladı:
Bu service-lər bir-biri ilə necə danışacaq?
İlk giriş nöqtəsi olaraq API Gateway
Frontend-in hər service-i ayrıca tanımasını istəmirdim. Əks halda frontend həm Auth Service-in, həm Wallet Service-in, həm Order Service-in, həm də digər service-lərin ünvanını bilməli olacaqdı. Service-lər dəyişdikcə frontend də dəyişməli olacaqdı. Ona görə frontend üçün bir giriş nöqtəsi API Gateway-i yaratdım.
İndi istifadəçinin göndərdiyi request əvvəlcə Gateway-ə gəlir. Burada authentication, authorization və rate limiting kimi ümumi yoxlamalar həyata keçirilir və bundan sonra request uyğun service-ə göndərilir. Bununla digər service-lərin hər biri öz üzərinə bütün security məntiqini götürməli olmur. Gateway sistemin qapısı kimi işləyir. Amma burada Gateway həm də əsas authentication işini görür, domain service isə öz business əməliyyatının hansı permission tələb etdiyini müəyyən edir. Məsələn Wallet Service istifadəçinin wallet məlumatını oxumaq üçün bir permission, dəyişmək üçün isə başqa permission tələb edə bilər. Gateway isə bu permission məlumatını request ilə birlikdə service-ə ötürür. Beləliklə authentication və business logic bir-birindən mümkün qədər ayrı qalır.
JWT-ni niyə Auth Service-də yaratdım?
İstifadəçi login olduqda token yaratmaq üçün xüsusi bir service lazımdır. Mən bunu Auth Service-də saxladım. Burada JWT RSA açarları ilə imzalanır. Tokeni yaratmaq üçün private key istifadə olunur, Gateway isə public key ilə onun düzgün olub-olmadığını yoxlayır. Bunun mənim üçün əsas üstünlüyü odur ki, Gateway token yaradan tərəfə çevrilmir. O, sadəcə gələn tokenə güvənmək üçün onun həqiqətən bizim sistem tərəfindən yaradıldığını yoxlayır. Beləliklə authentication-in mərkəzi Auth Service-də qalır, amma hər request üçün yenidən Auth Service-ə getmək məcburiyyəti yaranmır. Bu ayrılıq xüsusilə service sayı artdıqca daha vacib olur.
Logout məsələsində JWT ilə bağlı problem
JWT ilə işləyərkən ilk baxışda hər şey sadə görünür. Token yaradılır, müəyyən müddət keçəndən sonra vaxtı bitir. Amma istifadəçi logout etdikdə başqa bir problem yaranır. Tutaq ki, tokenin bitməsinə hələ 20 dəqiqə var. İstifadəçi artıq sistemdən çıxıb, amma həmin token hələ texniki olaraq keçərlidir. Bu vəziyyətdə sadəcə client tərəfində tokeni silmək kifayət etmir. Ona görə logout zamanı tokenin jti məlumatını Redis-də blacklist-ə əlavə etdim. Gateway sonrakı request-lərdə tokenin yalnız imzasını və müddətini yoxlamır, həmin jti-nin blacklist-də olub-olmadığını da yoxlayır. Beləliklə istifadəçi logout etdikdən sonra həmin token vaxtı bitənə qədər aktiv qalmaq məcburiyyətində olmur.
Authentication başqa şeydir, permission başqa
İstifadəçinin kim olduğunu bilmək kifayət deyil. Sistem həm də bilməlidir ki, həmin istifadəçi nə edə bilər. Məsələn biri wallet məlumatını oxuya bilər, amma dəyişə bilməz. Başqa bir istifadəçinin order yaratmaq icazəsi olmaya bilər. Admin isə daha geniş imkanlara sahib ola bilər. Role və permission məlumatlarını Auth Service-də saxladım. Amma hər request zamanı həmin məlumatları database-dən almaq çox baha başa gələ bilərdi. Bu səbəbdən permission məlumatlarını əvvəlcə Redis-də qruplaşdırdım, Gateway isə həmin məlumatları Caffeine local cache-də saxlayır. Beləliklə normal request zamanı sistemin hər dəfə database və ya Redis-ə getməsinə ehtiyac qalmır. Permission məlumatı Gateway-in öz yaddaşından daha sürətli şəkildə tapılır. Bu yanaşma request-lərin sayını artırdıqca xüsusilə faydalı olur.
Bəs permission dəyişəndə nə baş verir?
İndi başqa bir problem ortaya çıxır. Tutaq ki, admin istifadəçinin permission-larından birini dəyişdi. Database-də məlumat yeniləndi, Redis-də də yeni məlumat var. Amma Gateway-də həmin məlumat hələ Caffeine cache-də köhnə formada qala bilər. Bunun üçün permission dəyişdikdə Redis Pub/Sub istifadə olunur. Auth Service dəyişiklik barədə mesaj göndərir, Gateway bu mesajı qəbul edir və öz cache-ini yeniləyir. Beləliklə bir tərəfdən local cache-in sürətini qoruyuram, digər tərəfdən də dəyişikliklərin Gateway-ə çatmasını təmin edirəm. Burada əsas məqsəd sadədir: sürətli cache olsun, amma köhnə məlumatla uzun müddət işləməsin.
Niyə hər service ayrıca JWT parse etmir?
Bir variant belə ola bilərdi ki, hər service gələn JWT-ni ayrıca yoxlasın, Redis-ə getsin və permission məlumatını özü tapsın. Amma bu halda eyni məntiqi bir neçə dəfə yazmış olardım. Wallet Service JWT-nin necə yaradıldığını bilməli idi. Order Service də bilməli idi. Market Data Service də security infrastructure-ına daha çox bağlanmalı idi. Mən isə bunu mümkün qədər sadələşdirmək istədim. Gateway tokeni yoxlayır və istifadəçi haqqında lazım olan məlumatları request-ə əlavə edir. Domain service isə artıq JWT ilə yox, ona ötürülmüş permission məlumatı ilə işləyir.Məsələn Wallet Service üçün gələn request-də istifadəçinin adı və permission-ları header vasitəsilə ötürülür. Wallet Service həmin məlumatlara baxaraq konkret əməliyyatın icazəli olub-olmadığını yoxlayır. Beləliklə service artıq tokenin içini açmağa, Redis-ə getməyə və Auth Service-i çağırmağa ehtiyac duymur.
Niyə Kafka istifadə etdim?
İndi qeydiyyat prosesinə baxaq.
İstifadəçi qeydiyyatdan keçir və Auth Service istifadəçini yaradır. Amma qeydiyyatdan sonra başqa işlər də görülməlidir. Məsələn istifadəçiyə email göndərmək və onun üçün ilkin wallet-ləri yaratmaq lazımdır. Bunların hamısını Auth Service-in özündə edə bilərdim. Amma onda Auth Service həm email sistemini, həm də Wallet Service-i tanımalı olacaqdı. Bunun əvəzinə Auth Service sadəcə baş verən hadisəni bildirir. İstifadəçi yaradıldı. Bu məlumat Kafka üzərindən yayılır. Mail Service həmin event-i qəbul edib email göndərir. Wallet Service isə eyni event-dən istifadə edib istifadəçi üçün wallet yaradır. Beləliklə Auth Service digər service-lərin nə etdiyini idarə etmədən öz işini tamamlayır. Mənim üçün Kafka-nın əsas rolu məhz burada oldu: bir service-də baş verən hadisəni digər service-lərə asinxron şəkildə çatdırmaq.
Bəs niyə hər şeyi Kafka ilə etmədim?
Çünki bütün əməliyyatlar event əsaslı deyil. Məsələn istifadəçi order yaradır. Order Service istifadəçinin balansını reserve etməlidir. Burada nəticəni dərhal bilmək lazımdır. Balans kifayətdirmi? Reserve əməliyyatı uğurlu oldumu? Bu məlumatı sonradan event kimi almaq əvəzinə həmin anda cavab almaq daha məntiqlidir. Buna görə Order Service ilə Wallet Service arasında gRPC istifadə etdim. Order Service deyir ki, bu istifadəçinin müəyyən məbləğini reserve et. Wallet Service əməliyyatı yerinə yetirir və nəticəni dərhal qaytarır.
Burada yanaşma çox sadədir: hadisəni xəbər vermək üçün Kafka, dərhal cavab almaq lazım olanda isə gRPC istifadə et.
Order yaradılarkən balans niyə dərhal silinmir?
İstifadəçi 100 USDT-lik Botcoin almaq istəyir. Bu 100 USDT-ni order yaradılan anda birdəfəlik balansdan silmək düzgün olmazdı. Çünki order hələ icra olunmayıb və uğurlu olunmaya bilər. Mən buna görə reserve yanaşmasından istifadə etdim. İstifadəçinin pulunun bir hissəsi artıq istifadə oluna bilməyəcək şəkildə müvəqqəti bloklanır. Order uğursuz olarsa həmin məbləğ geri qaytarılır. Order uğurla icra olunarsa reserve olunmuş məbləğ artıq real transaction-a çevrilir. Bu yanaşma order prosesi zamanı eyni balansın başqa əməliyyatda istifadə edilməsinin qarşısını almaq üçün vacibdir. Burada Wallet Service öz business qaydasını qoruyur, Order Service isə sadəcə ondan lazım olan əməliyyatı tələb edir.
İndi “Buy” düyməsinin arxasına baxaq
İstifadəçi 100 USDT-lik Bitcoin almaq istəyir və düyməyə basır. Request əvvəlcə API Gateway-ə gəlir. Gateway tokeni və permission-ları yoxladıqdan sonra request Order Service-ə çatır. Order Service əvvəlcə Binance-dan Bitcoin-in cari qiymətini alır. Daha sonra istifadəçinin göndərdiyi büdcəyə əsasən neçə Bitcoin alınacağını hesablayır. Bu məlumatlar hazır olduqdan sonra Wallet Service-ə gRPC vasitəsilə müraciət edilir və lazımi məbləğ reserve olunur. Reserve uğurlu olarsa, Order Service Binance-a order göndərir. Burada istifadəçinin API məlumatları ilə şifrələnmiş request istifadə olunur. Binance order-i qəbul etdikdən sonra bizim database-də də həmin order saxlanılır və statusu yenilənir. İstifadəçi üçün isə proses yenə də sadəcə “Buy” düyməsindən ibarətdir.
Binance order-in statusunu necə izlədim?
Order yaradıldıqdan sonra iş bitmir. Order açıq qala bilər, qismən icra oluna bilər, tam icra oluna bilər və ya ləğv edilə bilər. Bu dəyişiklikləri real-time almaq üçün Binance User Data WebSocket connection-dan istifadə etdim. Məsələn order FILLED olduqda Binance-dan execution report gəlir. Order Service həmin məlumatı qəbul edir, order-in statusunu yeniləyir və Wallet Service-ə commit əməliyyatı göndərir.
Burada maraqlı olan odur ki, order-in yaradılması ilə order-in tamamlanması iki fərqli hadisədir. Birinci mərhələdə biz Binance-a request göndəririk. İkinci mərhələdə isə Binance-da baş verən dəyişikliklərin bizə çatmasını gözləyirik.
WebSocket kəsilsə nə olacaq?
Distributed sistem qurarkən ən maraqlı problemlərdən biri məhz budur. Tutaq ki, Binance order-i uğurla qəbul etdi. Bir neçə saniyə sonra order FILLED oldu. Amma həmin anda bizim WebSocket connection-da problem yarandı və executionReport bizə çatmadı. Binance öz tərəfində order-i tamamlamış olacaq. Amma bizim database-də köhnə status qala bilər. Bu səbəbdən mən yalnız WebSocket-ə güvənmədim. Order Service-də scheduler də var. Müəyyən intervallarla açıq order-lər yenidən Binance-dan yoxlanılır və lazım gəldikdə lokal vəziyyət düzəldilir. Beləliklə WebSocket mənə real-time məlumat verir, scheduler isə sistemin sonradan yenidən yoxlanılmasına kömək edir. Bu yanaşma mənə bir şeyi göstərdi: real-time event çox vacibdir, amma real-time event-ə kor-koranə güvənmək də olmaz.
Market məlumatlarını niyə ayrıca service etdim?
Order Service-in Binance ilə danışması bir problemdir. İstifadəçinin ekranda gördüyü Bitcoin qiymətini, chart məlumatlarını və digər market məlumatlarını idarə etmək isə başqa problemdir. Bu səbəbdən ayrıca Market Data Service yaratdım. Bu service Binance-dan ticker, kline və digər market məlumatlarını alır. Historical məlumatların saxlanılması və market analytics kimi işlər də burada cəmlənir. Beləliklə Order Service əsasən order prosesi ilə maraqlanır, Market Data Service isə bazardakı məlumatın toplanması ilə maraqlanır. Bu ayrılıq gələcəkdə sistem böyüdükcə daha rahat idarəetmə yaradır.
Market Data Service ilə Stream Service niyə ayrıdır?
Burada iki fərqli istiqamət var. Bir tərəfdə Binance-dan backend-ə məlumat gəlir. Digər tərəfdə isə backend-dən frontend-ə məlumat gedir. Mən bunları eyni service-in üzərinə yükləmək istəmədim. Market Data Service Binance ilə olan əlaqəni idarə edir. Stream Service isə frontend-in WebSocket connection-larına cavabdehdir. Market Data Service məlumatı aldıqdan sonra Redis vasitəsilə sistem daxilində paylaşır. Stream Service də həmin məlumatı qəbul edib frontend-ə göndərir. Beləliklə frontend-də istifadəçi sayı artdıqca Binance ilə olan əlaqənin eyni şəkildə böyüməsinə ehtiyac qalmır. Bu ayrılıq mənə daha rahat scaling imkanı verir.
Əgər 100 istifadəçi eyni anda bir symbol-u (məsələn, Bitcoin) izləyirsə, hər istifadəçi üçün ayrıca Binance WebSocket açılmır. Binance ilə yalnız 1 bağlantı qurulur və gələn data sistem daxilində çoxaldılaraq həmin 100 istifadəçiyə çatdırılır.
Market Data Service: Yalnız Binance ilə olan xarici WebSocket əlaqələrini qurur və idarə edir.
Stream Service: Frontend ilə olan daxili WebSocket əlaqələrinə cavabdehdir.
Redis burada nə edir?
Layihədə Redis-i sadəcə “cache” kimi istifadə etmədim. Bəzən token blacklist üçün lazım oldu. Bəzən permission məlumatlarının sürətli əldə olunmasına kömək etdi. Market məlumatlarının paylaşılmasında istifadə olundu. Real-time stream-lərin yayılmasında işə yaradı. WebSocket session və müəyyən state məlumatlarının saxlanılmasında da istifadə edildi. Yəni Redis sistemdə tək bir problemin həlli deyil. Fərqli yerlərdə fərqli məqsədlər üçün istifadə olunan ümumi infrastructure komponentidir. Bu, mənim üçün maraqlı dərslərdən biri oldu. Eyni texnologiya sistemin müxtəlif hissələrində istifadə oluna bilər, amma hər istifadənin səbəbi ayrıca olmalıdır.
Niyə bütün coin-lərin market məlumatını eyni anda izləmədim?
Binance-da çox sayda trading pair var. Amma istifadəçilərin həmin anda hamısına baxması mümkün deyil. Tutaq ki, hazırda istifadəçilər əsasən Bitcoin və Ethereum izləyirlər. Mən sistemin bütün mövcud symbol-lar üçün boş yerə məlumat toplamasını istəmirəm. Buna görə aktiv izlənən symbol-ləri ayrıca idarə etdim. İstifadəçilərin hansı symbol-lara baxdığı məlum olur və Market Data Service lazım olan stream-ləri buna uyğun idarə edə bilir. Beləliklə istifadə olunmayan məlumat üçün resurs xərcləmək azalır.
İstifadəçilərin hansı coin-lərə baxdığını niyə topladım?
İstifadəçilərin hansı symbol-lara daha çox baxdığını da sistem üçün faydalı məlumat hesab etdim. İstifadəçi bir symbol-a baxanda bu hadisə sistem daxilində qeyd olunur. Bu məlumat sonradan toplanaraq daha çox izlənən symbol-ləri müəyyən etməyə imkan verir. Beləliklə sistem təkcə market məlumatı göstərmir. Eyni zamanda hansı bazarların istifadəçilər üçün daha maraqlı olduğunu da anlamağa başlayır. Bu məlumat gələcəkdə analytics, recommendation və market səhifəsinin optimallaşdırılması üçün istifadə oluna bilər.
Historical market data necə həll olundu?
Real-time qiymət kifayət etmir. İstifadəçi chart açanda keçmiş məlumatları da görmək istəyir. Bu səbəbdən Market Data Service yalnız WebSocket ilə işləmədi. Binance-dan historical kline məlumatları da alınır və database-də saxlanılır. Sonra sistem müəyyən aralıqlarla yeni məlumatları yoxlayaraq lokal bazanı yeniləyə bilir. Beləliklə chart üçün lazım olan məlumatın hamısını hər dəfə xarici API-dən almaq məcburiyyətində qalmıram.
Email göndərməyi niyə ayrıca service etdim?
Email trading platformasının əsas business məntiqinə aid deyil. Ona görə istifadəçi qeydiyyatdan keçəndə Auth Service-in birbaşa email serveri ilə əlaqə saxlamasını istəmədim. Auth Service Kafka-ya event göndərir. Mail Service həmin event-i alır, hansı email-in göndərilməli olduğunu müəyyən edir və uyğun template ilə mesajı göndərir. Bu yanaşmanın ən gözəl tərəfi odur ki, email sistemində problem yaransa belə, istifadəçi qeydiyyatının əsas hissəsi email göndərmək səbəbindən bloklanmır.
Telegram AI Bot niyə əlavə etdim?
Trading platformasının yalnız order və market məlumatından ibarət olmasını istəmədim. İstifadəçi Telegram vasitəsilə də kriptovalyuta haqqında sual verə bilsin istədim.
Məsələn “Bitcoin nədir?”, “Bitcoin haqqında son xəbərlər hansılardır?” və ya marketlə bağlı müəyyən suallar verə bilər. Burada artıq sadə Telegram botundan çox, müxtəlif məlumat mənbələrini və AI modelini birləşdirən ayrıca service ortaya çıxır. İstifadəçinin Telegram-dan göndərdiyi mesaj sistemə daxil olur, söhbət tarixçəsi nəzərə alınır və sualın hansı məlumatdan istifadə etməli olduğunu müəyyənləşdirmək üçün AI-dan da yararlanılır.
RAG burada nə üçün lazımdır?
Sadəcə Gemini-yə sualı göndərib cavabı gözləmək kifayət etmirdi. Çünki modelin hər zaman bizim topladığımız konkret xəbərlərə və ya kriptovalyuta məlumatlarına birbaşa çıxışı yoxdur. Buna görə əvvəlcə məlumatları toplayıb vector database-ə yerləşdirdim. Xəbərlər və kripto terminologiyası sistemə daxil olur, daha kiçik hissələrə bölünür və vector məlumatına çevrilərək PostgreSQL-də pgvector üzərindən saxlanılır. İstifadəçi sual verdikdə əvvəlcə həmin suala uyğun məlumat axtarılır. Sonra tapılan məlumat Gemini-yə ötürülür və cavab bu kontekst nəzərə alınaraq hazırlanır. Yəni model cavabı tam boşluqdan yaratmır. Əvvəlcə sistem öz məlumatları içərisində uyğun məlumatı tapmağa çalışır.
Hər sualda eyni məlumat mənbəyindən istifadə etmirəm
Burada daha maraqlı bir problem ortaya çıxır.
Məsələn istifadəçi “Bitcoin nədir?” deyirsə, bu daha çox bilik və terminologiya tipli sualdır. Amma “BTC son 24 saatda neçə faiz dəyişib?” deyirsə, artıq real market məlumatı lazımdır. Bu səbəbdən Telegram AI Bot-da sualın hansı mənbəyə yönləndirilməli olduğunu müəyyən edən məntiq qurdum. Bəzi suallar PostgreSQL-dən məlumat tələb edir, bəzi suallar isə vector search-ə gedir. Sual kriptovalyuta və maliyyə bazarı mövzusundan kənardadırsa, sistem onu da müəyyən edə bilir. Beləliklə AI hissəsi yalnız bir model çağırışından ibarət olmur. Əvvəlcə məlumatın haradan gəlməli olduğu müəyyən edilir, sonra həmin məlumat cavabın hazırlanmasında istifadə olunur.
Bot əvvəlki söhbəti necə xatırlayır?
İstifadəçi botla danışarkən ikinci sual çox vaxt birinci sualdan asılı olur.
Məsələn əvvəl “Bitcoin haqqında danış” deyilir, sonra “Bəs son həftə necə olub?” sualı verilir. İkinci sualın mənasını başa düşmək üçün botun əvvəlki söhbəti bilməsi lazımdır. Buna görə chat history database-də saxlanılır və yeni sual hazırlanarkən əvvəlki mesajlar da kontekstə daxil edilir. Beləliklə bot yalnız son cümləni deyil, söhbətin ümumi kontekstini də nəzərə alır.
PostgreSQL niyə həm business data, həm də vector data üçün istifadə olundu?
Layihənin əsas database-i PostgreSQL-dir.
Burada user, role, permission, wallet, order və digər business məlumatları saxlanılır. AI hissəsində isə pgvector vasitəsilə embedding-lərin saxlanılması və similarity search həyata keçirilir. Başlanğıc mərhələsində ayrıca vector database qurmaq əvəzinə PostgreSQL-dən bu məqsədlə də istifadə etmək infrastructure-u bir qədər sadələşdirir. Beləliklə bir database həm klassik relational məlumatları, həm də AI üçün lazım olan vector məlumatlarını saxlaya bilir.
Microservice-lərdə ən çətin hissə service yaratmaq deyil
Əslində bir neçə Spring Boot project yaratmaq çətin deyil. Çətinlik service-lər bir-biri ilə əlaqəyə başladıqda ortaya çıxır. Monolith-də bir method digər method-u çağırır. Microservice-də isə artıq network var. Network timeout verə bilər. Service cavab verməyə bilər. Event gecikə bilər. WebSocket kəsilə bilər. Database-də bir əməliyyat uğurlu olub, növbəti mərhələ uğursuz ola bilər. Məsələn Wallet Service balansı reserve etdi, amma Binance order-i qəbul etmədi. Bu halda reserve olunan məbləğ geri qaytarılmalıdır. Yaxud Binance order-i qəbul etdi, amma bizim WebSocket event-i almadıq. Bu halda sistem sonradan Binance ilə öz vəziyyətini müqayisə etməlidir. Distributed sistemdə mənim üçün əsas sual getdikcə belə dəyişdi: “Bu request necə işləyəcək?” əvəzinə “Bu request yarıda qalsa nə olacaq?” sualı daha vacib oldu.
Docker bütün bunları necə birləşdirdi?
Bu qədər service və infrastructure komponentini əl ilə idarə etmək development zamanı çox rahat deyil. Buna görə layihədə Docker Compose-dan istifadə etdim. PostgreSQL, Redis, Kafka və digər infrastructure komponentləri birlikdə qaldırıla bilir. Kafka üçün bir neçə broker-dən ibarət KRaft quruluşu da istifadə olunur. Beləliklə layihəni işlətmək üçün bütün infrastructure-u ayrıca quraşdırmaq və bir-bir idarə etmək lazım gəlmir. Bu, development prosesində kifayət qədər vaxt qazandırır.
Sonda sistemə yenidən istifadəçi gözü ilə baxaq
İstifadəçi qeydiyyatdan keçir.
Auth Service hesabı yaradır və digər service-lərin görə biləcəyi event-ləri Kafka-ya göndərir. Wallet Service həmin event-i qəbul edib wallet yaradır. Mail Service isə email göndərir.
İstifadəçi login olur və Auth Service JWT yaradır. Frontend-dən gələn request-lər API Gateway-ə düşür. Gateway tokeni yoxlayır, istifadəçinin permission-larını müəyyən edir və request-i uyğun service-ə ötürür. İstifadəçi Botcoin səhifəsini açır. Market Data Service Binance-dan real-time məlumat alır. Redis bu məlumatın sistem daxilində yayılmasına kömək edir. Stream Service isə həmin məlumatı WebSocket vasitəsilə frontend-ə göndərir. İstifadəçi “Buy” düyməsinə basır. Request Gateway-dən keçir, Order Service işə düşür, ə Wallet Service balansı reserve edir və Binance-a order göndərilir. Binance order-in statusunu WebSocket vasitəsilə bildirir. Order tamamlandıqda Wallet Service-də commit əməliyyatı aparılır. WebSocket connection kəsilərsə, scheduler ilə order-i sonradan yenidən yoxlayır. İstifadəçi Telegram-da sual verəndə isə tamam başqa bir proses başlayır. Telegram AI Bot söhbətin tarixçəsini nəzərə alır, sual üçün uyğun məlumat mənbəyini müəyyən edir, lazım olduqda PostgreSQL və ya vector search-dən məlumat götürür və sonda Gemini həmin məlumat əsasında cavab hazırlayır. İstifadəçi isə bütün bunların heç birini görmür. Onun üçün sadəcə login ekranı, market səhifəsi, chart və “Buy” düyməsi var. Backend üçün isə həmin bir düymənin arxasında bir neçə service eyni anda işləyir.
Mənə görə bu layihənin əsas nəticəsi
Bu layihədə çoxlu texnologiya istifadə etdim.
Spring Boot, Spring Cloud Gateway, JWT, Redis, Caffeine, Kafka, gRPC, WebSocket, PostgreSQL, pgvector, Gemini və Binance API. Amma layihənin sonunda mənim üçün ən vacib nəticə texnologiyaların sayı olmadı. Əsas nəticə bu oldu ki, microservice arxitekturası sadəcə application-ı bir neçə project-ə bölmək deyil. Əsas məsələ hansı service-in hansı məsuliyyətə sahib olduğunu müəyyən etməkdir. Auth authentication-ı idarə edir. Gateway sistemin giriş nöqtəsi olur. Wallet balansı qoruyur. Order trading prosesini idarə edir. Market Data Binance-dan market məlumatını toplayır. Stream həmin məlumatı frontend-ə çatdırır. Kafka service-lərin bir-birinə daha az bağlı şəkildə event-lərlə işləməsinə kömək edir. Redis müxtəlif sürətli və paylanmış məlumat ehtiyaclarını həll edir. gRPC service-lər arasında dərhal cavab tələb edən daxili əməliyyatlar üçün istifadə olunur. WebSocket real-time məlumatı çatdırır. RAG və Gemini isə sistemin üzərinə AI layer əlavə edir. Amma bütün bunların arasında ən vacib hissə texnologiyaların özü deyil. Əsas məsələ sistemin bir hissəsində problem yarandıqda qalan hissələrin necə davranacağını əvvəlcədən düşünməkdir. Çünki real sistemdə heç nə həmişə problemsiz işləmir. Network kəsilir. Service dayanır. Event gecikir. Cache köhnəlir. External API cavab vermir. WebSocket bağlanır. Və yaxşı arxitekturanın məqsədi bütün problemlərin heç vaxt baş verməməsi deyil.
Məqsəd odur ki, problem baş verdikdə sistem mümkün qədər düzgün vəziyyətdə qala bilsin.
Mənim üçün bu layihənin əsas öyrətdiyi də məhz bu oldu:
Microservice yazmaq service-ləri çoxaltmaq deyil. Microservice yazmaq, sistemdə yaranacaq problemləri əvvəlcədən düşünərək məsuliyyətləri düzgün bölməkdir.
Sonda qısa olaraq sistem necə işləyir?
İstifadəçinin bütün request-ləri API Gateway-dən keçir. Mən Gateway-i ayrıca yaratmaqla frontend-in bütün service-ləri bir-bir tanımasının qarşısını almaq istədim. Eyni zamanda authentication, authorization və rate limiting kimi ümumi məsələləri bir nöqtədə idarə etmək daha rahat oldu. İstifadəçi login olduqda JWT Auth Service tərəfindən yaradılır. Burada RS256 istifadə olunur. Private key yalnız token yaratmaq üçün Auth Service-də qalır, Gateway isə public key vasitəsilə tokeni yoxlayır. Beləliklə digər service-lər token yaratmaq üçün lazım olan private key-dən xəbərsiz qalır. Permission məlumatları da Auth Service tərəfindən idarə olunur. Hər request zamanı database-ə getməmək üçün məlumatlar Redis-də saxlanılır və Gateway tərəfində Caffeine local cache istifadə olunur. Permission dəyişəndə isə Redis Pub/Sub vasitəsilə Gateway-ə məlumat verilir ki, köhnə cache yenilənsin. Service-lər arasında əlaqədə də hər yerdə eyni protokoldan istifadə etmədim. Bir service-də hadisə baş verəndə və bunun digər service-lərə asinxron şəkildə çatdırılması lazım olanda Kafka istifadə olunur. Məsələn user yaradıldıqda Mail və Wallet Service-lər bununla bağlı event-i Kafka-dan ala bilir. Amma Order Service Wallet Service-dən balansın reserve olunmasını istəyirsə, burada cavabı dərhal bilməli olduğumuz üçün gRPC daha uyğun olur. Trading hissəsində Order Service Binance ilə REST API vasitəsilə order əməliyyatlarını həyata keçirir. Order-in sonrakı vəziyyəti isə Binance WebSocket vasitəsilə izlənilir. Mən bu iki yanaşmanı birlikdə istifadə etdim, çünki REST request göndərmək üçün, WebSocket isə real-time status dəyişikliklərini almaq üçün daha uyğundur. Market məlumatlarında da oxşar yanaşma var. Market Data Service Binance-dan real-time məlumatları alır və sistem daxilində paylaşır. Redis burada məlumatın service-lər arasında yayılmasına kömək edir. Stream Service isə həmin məlumatları frontend-ə WebSocket vasitəsilə göndərir. Beləliklə Binance ilə olan connection frontend connection-larından ayrılmış olur. Əsas business məlumatları PostgreSQL-də saxlanılır. Burada user, role, permission, wallet, order və digər məlumatlar yerləşir. AI tərəfində isə pgvector istifadə edərək embedding-ləri də PostgreSQL-də saxlamaq mümkündür. Bunun üstünlüyü ilkin mərhələdə ayrıca vector database əlavə etmədən mövcud infrastructure-dan istifadə etməkdir. Bu qərarların hər birinin arxasında əsas məqsəd eynidir: bir service-in üzərinə başqa service-lərin məsuliyyətini yığmamaq və hər problemi həmin problem üçün daha uyğun texnologiya ilə həll etmək.
Bəs istifadəçi sayı 1000 və ya 1 milyon olsa?
Hazırkı sistemdə istifadəçi sayını sadəcə artırmaq kifayət etməyəcək. İstifadəçi sayı böyüdükcə sistemin müxtəlif hissələrində fərqli bottleneck-lər ortaya çıxacaq.
100 istifadəçi səviyyəsində əksər komponentlər üçün problem görmək çətin ola bilər. 1000 istifadəçidə isə request sayı, WebSocket connection-lar və database üzərindəki yük artıq daha ciddi hiss olunmağa başlayacaq. Bu mərhələdə service-ləri bir neçə instance kimi işlətmək və yükü onların arasında bölmək mümkün olacaq.
Amma 1 milyon istifadəçi artıq tamam başqa vəziyyətdir. Xüsusilə real-time market məlumatlarını izləyən istifadəçilərin sayı çoxdursa, WebSocket connection-lar böyük yük yarada bilər. Burada Stream Service-in bir neçə instance-da işləməsi, connection-ların düzgün paylanması və market məlumatlarının bir connection-dan çox sayda istifadəçiyə yayılması vacib olacaq.
Database də zamanla əsas bottleneck-lərdən birinə çevrilə bilər. Order və transaction məlumatları sürətlə artdıqca indexing təkbaşına kifayət etməyə bilər. Read replica, partitioning və gələcəkdə database-in service-lər üzrə ayrılması kimi yanaşmalar gündəmə gələ bilər. Kafka-da event sayı artdıqca partition və consumer sayını artırmaq lazım gələcək. Redis də eyni şəkildə çoxlu responsibility daşıdığı üçün böyük load altında ayrıca optimizasiya tələb edə bilər.
Amma burada mənim üçün ən maraqlı məsələ server sayını artırmaq deyil. Service-ləri çoxaltdıqda onların state-i necə paylaşacağını, eyni order-in iki dəfə işlənməsinin qarşısını necə alacağımızı və sistemin müxtəlif hissələri arasındakı consistency-ni necə qoruyacağımızı düşünmək lazım olacaq. Yəni 1 milyon istifadəçiyə çatanda problem sadəcə “daha güclü server” olmayacaq. Problem artıq “daha böyük distributed system” olacaq.
Harada improvement görürəm?
Market Data Service-də connection sayı böyüyə bilər: Hazırda Market Data Service Binance ilə WebSocket connection-ları özü idarə edir və aktiv symbol-lərə görə subscription-ları yeniləyir. Bu yaxşı yanaşmadır, amma service bir neçə instance-a bölündükdə başqa problem yaranır. Məsələn iki Market Data Service instance-ı işləyirsə, hər ikisinin eyni Binance stream-lərinə ayrıca qoşulması mümkündür. Bu zaman eyni məlumatı iki dəfə almaq və lazımsız connection yaratmaq problemi ortaya çıxa bilər. Sistem böyüdükcə Binance connection-larının hansı instance tərəfindən idarə olunacağını ayrıca koordinasiya etmək lazım gələ bilər.
Order prosesində idempotency daha güclü olmalıdır: Məsələn istifadəçi Buy düyməsinə basdı və request Binance-a göndərildi. Binance order-i qəbul etdi, amma bizim service response-u ala bilmədi. Biz bunu timeout kimi görüb eyni request-i yenidən göndərsək, ikinci order yaratmaq riski yaranır. Trading sistemi üçün bu kifayət qədər ciddi problemdir. Ona görə order creation kimi əməliyyatlarda idempotency key və daha dəqiq retry strategiyası tətbiq etmək maraqlı improvement olardı. Burada məqsəd sadədir: eyni əməliyyat nə qədər təkrar gəlsə də, order yalnız bir dəfə yaransın.
Layihədə Redis bir neçə fərqli məqsədlə istifadə olunur. Permission cache, blacklist, session/state, market data və digər məlumatlar eyni infrastructure-a düşür. Bu, hazırda rahatdır. Amma load artdıqca Redis-in bir nöqtədə bottleneck-ə çevrilməsi mümkündür. Məsələn market data çox sürətli gəlirsə və eyni zamanda minlərlə istifadəçinin session və cache məlumatı da Redis-də saxlanılırsa, artıq Redis-in ayrıca optimallaşdırılması və hətta bəzi məsuliyyətlərin ayrılması lazım gələ bilər.
Gateway bütün request-lərin keçdiyi nöqtədir. Bu, architecture baxımından rahatdır, amma eyni zamanda onu kritik komponentə çevirir. Əgər authentication, permission, blacklist və rate limiting kimi yoxlamaların hamısı burada gedirsə, yüksək traffic zamanı Gateway CPU və memory baxımından yüklənə bilər. Buna görə Gateway-in stateless saxlanılması və bir neçə instance kimi işlədilməsi vacib olacaq.
Kafka consumer-lar çoxaldıqca event-lərin idarəsi çətinləşə bilər: İndi Kafka əsasən user yaradılması və müxtəlif asinxron proseslər üçün istifadə olunur. İstifadəçi sayı artdıqca event sayı da artacaq. Burada artıq yalnız Kafka-nın işləməsi kifayət deyil. Consumer-ların gecikməsi, mesajların təkrar emal olunması və müəyyən event-in uğursuz olduqda nə baş verəcəyi də vacib olacaq. Xüsusilə Wallet və Mail kimi consumer-lərdə eyni event-in iki dəfə gəlməsi problem yarada bilər. Bu səbəbdən consumer tərəfdə də idempotency və retry mexanizmi vacib olacaq.
Observability çatışmazlığı: Bu qədər service olduqda ən böyük problemlərdən biri bug-un özündən çox bug-un harada yarandığını tapmaq ola bilər.
Məsələn user deyir: “Order yaratmaq istədim, alınmadı.” Problem Gateway-də ola bilər. Order Service-də ola bilər. Wallet Service-də ola bilər. Binance-da ola bilər. Kafka event-ində ola bilər. Database-də ola bilər. və s.
Buna görə gələcəkdə centralized logging, metrics və distributed tracing əlavə etmək çox faydalı olar.
AI məlumatlarının köhnəlməsi: RAG sistemində məlumatı bir dəfə vector database-ə yazmaq kifayət etmir. Xüsusilə news məlumatı istifadə olunursa, köhnə məlumat zaman keçdikcə dəyərini itirir. Məsələn bir neçə gün əvvəlki xəbərlə bugünkü xəbərin eyni çəkidə axtarılması düzgün nəticə verməyə bilər. Burada məlumatların periodik yenilənməsi, köhnə məlumatların silinməsi və ya relevance ilə birlikdə tarix faktorunun da nəzərə alınması lazım gələ bilər. Layihədə artıq periodik RAG data job-ları olduğu üçün bu istiqamətdə daha da inkişaf etmək məntiqli görünür.
Bir service-in dayanması məsələsi: Hazırda sistem bir neçə service-dən ibarətdir. Amma bəzi service-lər digərləri üçün vacib dependency-dir. Məsələn Redis dayanarsa Gateway-in bəzi funksiyaları problem yaşaya bilər. Kafka dayanarsa asinxron proseslər dayanacaq. Wallet Service işləməsə order creation prosesi davam edə bilməz. Bu səbəbdən gələcəkdə circuit breaker, timeout, retry və fallback kimi mexanizmlər daha vacib olacaq. Amma burada da hər yerə retry əlavə etmək düzgün deyil. Xüsusilə order kimi əməliyyatlarda yanlış retry yeni problem yarada bilər.
Bu layihəni qurarkən çoxlu texnologiya istifadə etdim, amma mənim üçün əsas məsələ həmin texnologiyaların sayı olmadı. Əsas məsələ hər birini konkret problemin həlli üçün seçmək idi.
Kafka-nı hər communication üçün istifadə etmək əvəzinə event əsaslı proseslərdə istifadə etdim. gRPC-ni isə dərhal cavab almağın vacib olduğu daxili əməliyyatlarda saxladım. Redis-i yalnız cache kimi deyil, sistemin müxtəlif hissələrində lazım olan shared state və real-time məlumatlar üçün də istifadə etdim. WebSocket-i isə həm Binance-dan gələn real-time məlumatların, həm də frontend-ə gedən məlumatların idarəsində fərqli məqsədlərlə istifadə etdim.
Amma sistem böyüdükcə bu qərarların bəzilərinin dəyişməsi tam normaldır. Ona görə bu layihəyə başqa bir developer gözü ilə baxmaq mənim üçün daha maraqlıdır.
Siz bu arxitekturda nəyi fərqli edərdiniz?
100 min və ya 1 milyon istifadəçi halında sizcə ilk bottleneck harada yaranar?
Kafka, Redis, WebSocket, database və ya service boundaries baxımından daha yaxşı yanaşma gördüyünüz yer varmı?
Bu layihədə məqsədim “ideal architecture” göstərmək deyil.
Məqsədim real bir layihə üzərində verilən architectural qərarları paylaşmaq və həmin qərarların başqa insanlarda hansı suallar yaratdığını görməkdir.
Ona görə feedback-lərinizi, xüsusilə “mən bunu belə edərdim” dediyiniz hissələri səbəbi ilə birlikdə bölüşsəniz, mənim üçün çox faydalı olar.
Layihənin tam source kodunu və arxitektur qərarların video izahını aşağıdakı linklərdən izləyə bilərsiniz:
5 человек прочитали эту статью


Комментарии
Войдите, чтобы оставить комментарий. Войти